CloudRobo-WM1.2 具身世界模型达成 88.98% 操作成功率,支持 33 种机器人本体的 96 维状态输入
华为云在 2026 年 11 月 16 日发布昇腾原生具身世界模型 CloudRobo-WM1.2,在 RoboTwin 2.0 基准测试中取得 88.98% 平均成功率,LIBERO-Pro 2.0 达到 81.73%。第三方独立测试覆盖 5 种机器人本体、13 项操作任务,真机成功率领先 23 个百分点。
模型整合 20 个数据源的 2.75 万小时训练数据,支持 33 种本体的 96 维状态输入和 168 维人类运动表征。
关键参数
| 参数 | 数值 | 说明 |
|---|---|---|
| RoboTwin 2.0 平均成功率 | 88.98% | 标准基准测试表现 |
| LIBERO-Pro 2.0 平均成功率 | 81.73% | 多任务泛化能力测试 |
| 第三方真机测试领先幅度 | 23 百分点 | 5 种本体 13 项任务的独立验证 |
| 训练数据时长 | 2.75 万小时 | 接入 20 个数据源 |
| 支持本体种类 | 33 种 | 覆盖机械臂、双臂、人形机器人 |
| 本体状态维度 | 96 维 | 关节角度、力矩、位置等状态 |
| 人类运动表征维度 | 168 维 | 骨骼节点位置与姿态编码 |
| 7B 参数模型显存需求 | 112 GB | 全精度推理所需显存容量 |
| 推理模式计算量差异 | 11 倍 | 最重与最轻模式的算力倍数 |
| 视频流数据速率 | 4 Mbps × 2 路 | 双目 RGB 输入带宽需求 |
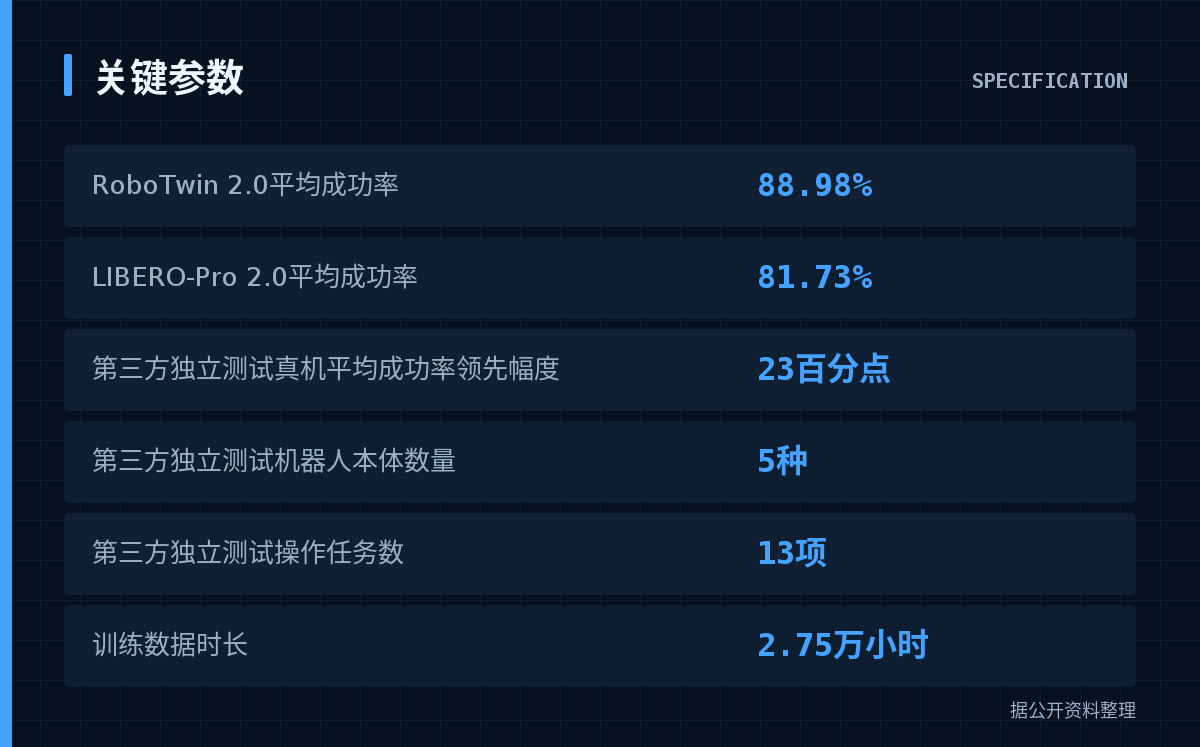
图:关键参数图
技术拆解
PPA 多模态世界表征架构
CloudRobo-WM1.2 采用 PPA(Perception-Prediction-Action)架构处理多源输入数据。模型接收 RGB 视频、DINO 语义特征、深度信息和三维点云四种模态,通过预训练的视觉编码器提取空间语义特征后,将这些特征与机器人本体的 96 维状态数据融合。单次推理接收 2 路 4 Mbps 视频流,8000 小时训练数据压缩后占用 28.8 TB 存储空间。
图:架构与数据路径
DualAct 双路径动作生成
模型内部分为 action expert 动作专家分支和 world generator 世界模型骨干两路。动作专家分支直接输出控制指令,世界模型骨干预测未来状态序列后再生成动作。两路计算量相差 11 倍,系统根据任务复杂度自动选择执行路径。第三方测试显示,简单操作任务中动作专家分支响应更快,需要多步推理的任务中世界模型骨干精度提升明显。
本体语义保真跨具身运动建模
模型通过统一编码器将 33 种机器人本体的运动数据映射到共享表征空间。人类演示数据编码为 168 维向量,包含关键骨骼节点的三维坐标和姿态角度。机器人本体状态编码为 96 维向量,涵盖关节角度、末端执行器位置和力传感器读数。这种设计让模型能够将人类操作经验迁移到不同机械结构的本体上执行相同任务。
昇腾算力适配与数据流水线
华为云将模型训练与推理流程适配到昇腾 NPU 和鲲鹏处理器架构。数据预处理由鲲鹏处理器完成,张量运算和梯度计算分配给昇腾 NPU。适配后推理效率和训练吞吐提升 2-3 倍。模型支持 GR00T N1.5/N1.6 架构下单位时间动作计算提升 195%-278%,StarVLA 架构下训练调用吞吐提升 186%-240%。
多粒度监督与数据成本
训练数据来自 20 个数据源,包含真机遥操作记录、仿真环境生成数据和人类演示视频。真机数据采集成本为 500-1000 元/小时,存量有效数据规模达到 100 万小时级。模型采用多粒度监督掩码策略,在视频帧级、动作序列级和任务级分别设置损失函数,让模型同时学习短期动作执行和长期任务规划。
横向对比
| 模型架构 | 单位时间动作计算提升下限 | 单位时间动作计算提升上限 |
|---|---|---|
| GR00T N1.5 和 N1.6 | 195% | 278% |
| StarVLA | 186% | 240% |
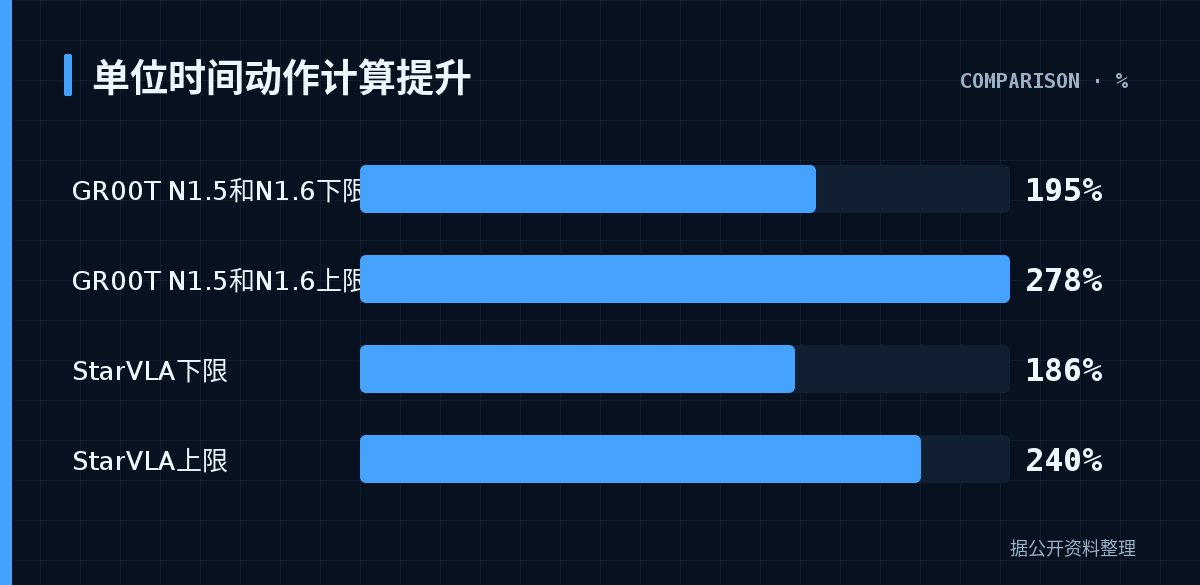
图:横向参数对比
对工程师意味着什么
算力与内存带宽要求
7B 参数模型的 112 GB 显存需求超过单张消费级显卡容量,部署需使用多卡并行或服务器级加速卡。昇腾 NPU 的算力适配方案可将推理效率提升 2-3 倍,但开发者需评估现有硬件平台是否支持华为云的推理框架。视频流输入的 8 Mbps 总带宽(2 路 × 4 Mbps)对网络传输要求不高,但实时推理需保证摄像头帧率与模型推理频率同步。
本体适配与数据准备
模型支持 33 种本体,但新本体接入需提供标准化的 96 维状态输出接口。开发者需编写本体状态到标准格式的转换层,包括关节编号映射、坐标系对齐和单位换算。如果本体不在已支持列表中,需采集至少数百小时操作数据进行微调,按真机采集成本 500-1000 元/小时计算需要相应投入。
工具链与开源时间表
华为云计划在 11 月 30 日开放模型权重、推理代码和后训练代码。开发者可获取预训练模型权重文件、本地推理脚本和针对特定任务的后训练样例。昇腾算力适配的训练代码依赖 CANN(Compute Architecture for Neural Networks)工具链,需在支持昇腾 NPU 的服务器环境中运行。华为云具身智能专区已吸引 230 家企业及高校、1.65 万名开发者,积累 1500 项行业资产覆盖 20 多个行业。
推理模式选择
DualAct 架构的四种推理模式在计算量上相差 11 倍。工程师需根据任务延迟要求和精度需求选择模式。简单拾取任务可用动作专家分支降低延迟,复杂装配任务需启用世界模型骨干提升成功率。模式切换逻辑可由上层任务规划器控制,也可通过强化学习训练自动切换策略。
功耗与散热设计
7B 参数模型在全精度推理下的功耗取决于硬件平台。部署在机器人本体上时,推理计算通常放在边缘服务器或云端,本体只需传输视频流和状态数据,对本体自身功耗影响有限。昇腾 NPU 相比通用 GPU 在推理效率上提升 2-3 倍,对应功耗密度也会降低(估算)。
尚待验证
- 模型在不同硬件平台上的迁移性能损失:需在 NVIDIA GPU、AMD GPU 和其他 NPU 上测试推理延迟和精度变化,量化昇腾专用优化带来的性能差异。
- 长视频序列并行计算的通信开销:2.75 万小时训练数据分布式训练时,节点间梯度同步和视频特征传输的带宽占用和延迟需实测。
- 多粒度监督掩码对最终模型精度的影响:单独测试帧级、序列级和任务级损失函数的权重配比,确定最优监督策略。
- 四种推理模式在实际部署中的能耗差异:测量动作专家分支和世界模型骨干在不同任务下的实际功耗,建立能耗-精度曲线。
- 本体语义保真建模在超过 33 种本体时的泛化能力:测试模型对未见过的机械结构(如软体机器人、六足机器人)的零样本迁移效果。
- PPA 架构在极端遮挡场景下的鲁棒性边界:量化物体遮挡比例超过特定阈值时模型的成功率下降曲线。
- DualAct 两路径在不同任务类型下的自动切换策略:收集实际部署数据,训练路径选择器或建立启发式规则库,验证切换准确率。
- CloudRobo-WM1.2 具身世界模型达成 88.98% 操作成功率,支持 33 种机器人本体的 96 维状态输入
- 超声波流量计的技术特点及应用优势
- 5V100mA非隔离小家电电源芯片LP2188AL解析,LP2188AL替代AP8501
- 思大电子防水USB系列连接器为自动化平台打造稳定可靠的数据通道
- IBM侯淼畅谈企业AI规模化落地的解决方案
- 库库,服务全球的中国AI样本
- 意法半导体L4983控制IC助力电动自行车充电器开发
- 燧原科技率先支持腾讯混元Hy4大语言模型
- 阻抗分析仪E4990A怎么测电缆特性阻抗
- 微硬创新 PROFINET嵌入式协议转换板卡:从引脚定义到状态字反馈的技术要点说明
- 介绍一种基于规则的温漂分析方法
- 罗莱迪思亮相2026香港秋灯展
- 液冷 CDU 管路洁净工艺|一文看懂管道清洗烘干一体机
- 功率半导体大厂芯联集成发布三季报!
- 电路板设计工具PADS最新软件安装与配套视频课程
- 安科瑞 ANSNP 中线安防保护器,N 线电流直降九成!